Dobrý magazín žije svými příběhy. Technologie v jeho pozadí ale ovlivňuje, jak snadno se k nim dostanete a zda objevíte další článek, který vás zaujme. Při tvorbě nového jsme.cz jsme proto věnovali pozornost také tomu, co na první pohled není vidět: způsobu, jakým ukládáme, propojujeme a zpřístupňujeme obsah.
Databáze pro propojený obsah
Naším datovým základem se stala Relatude.DB, otevřená databáze pro C# a .NET, která spojuje objektový a grafový model s integrovaným vyhledáváním. Za jejím vývojem stojí norská společnost Proventus AS, tvůrce platforem Relatude CMS a Relatude E-commerce. Databáze tak navazuje na zkušenosti se správou obsahu a vývojem webových aplikací. Více o společnosti
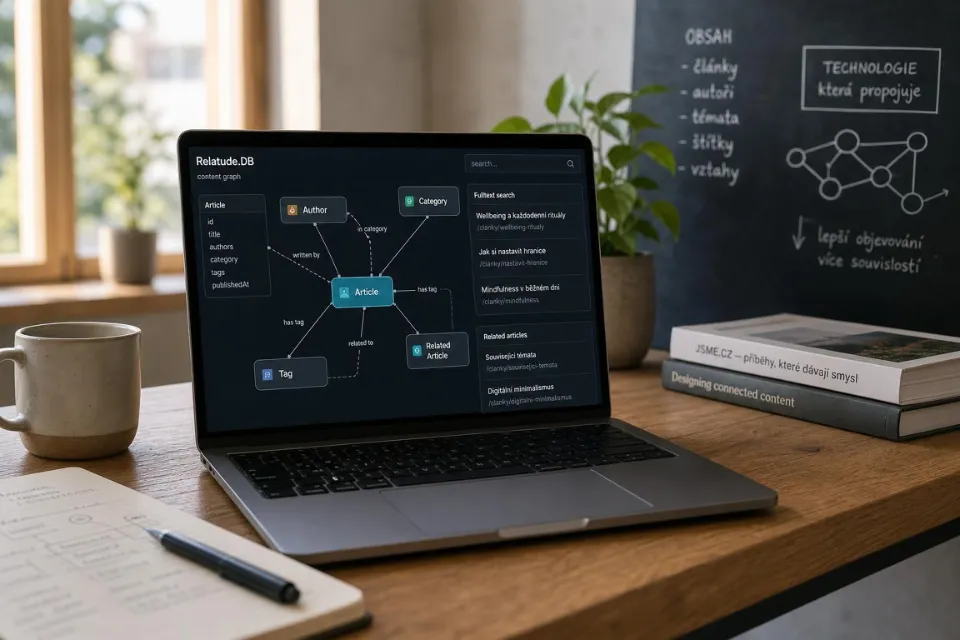
Článek má své autory, rubriku, tematické štítky a vazby na další texty. Relatude.DB pracuje s těmito vztahy přímo jako se součástí databázového modelu. Na jsme.cz tento základ využíváme k propojení obsahu, aby čtenáři mohli pokračovat podle tématu, které je zajímá, nebo objevovat další tvorbu oblíbeného autora.
S každým dalším článkem roste také hodnota souvislostí mezi příběhy.
Přímější cesta k datům
Databázový engine běží přímo v našem aplikačním backendu, takže jeho přístup k datům nevyžaduje síťovou komunikaci se samostatným databázovým serverem. Pro tuto datovou vrstvu nepotřebujeme SQL Server ani Entity Framework, což zjednodušuje její provoz.
Rychlost webu vzniká spoluprací všech jeho částí. Relatude.DB proto doplňuje serverové vykreslování stránek, mezipaměť pro vybrané veřejné odpovědi API a vlastní zpracování obrazových variant. Společně omezují zbytečně opakovanou práci při procházení magazínu.
Vyhledávání ve společném úložišti
S rostoucím archivem nabývá na významu vyhledávání. Na jsme.cz jsme proto propojili klasické hledání podle slov s hledáním podle významu. Základem zůstává nativní fulltextové vyhledávání Relatude.DB s hodnocením relevance BM25, které přikládá vyšší váhu nadpisům a podporuje hledání podle začátků slov. Nově jej doplňuje sémantická podobnost mezi dotazem a obsahem článků.
Oba přístupy se při sestavování výsledků doplňují. Shoda slov pomáhá dohledat konkrétní výraz, zatímco významová podobnost může přivést čtenáře k textu, který stejné téma popisuje jinak. Nemusíte tak předem znát formulaci, kterou autor použil.
Fulltextový i vektorový index spravuje Relatude.DB ve společném databázovém úložišti. Veřejné vyhledávání zároveň kontroluje aktuální publikační stav článků, aby nabízelo pouze obsah dostupný čtenářům.
Vektorové a sémantické hledání
Sémantické hledání pracuje s číselnou reprezentací textu, takzvaným vektorem. Ten umožňuje porovnávat významovou podobnost dotazu a článků. Na jsme.cz tuto reprezentaci vytváříme z titulku, úvodu a textů odstavců i připojených informačních boxů. U delších článků zpracováváme text po částech a jejich výsledky spojujeme.
Pro tvorbu vektorů využíváme model OpenAI. Relatude.DB zajišťuje jejich ukládání, indexování a opakované využití již zpracovaného textu. Samotné porovnávání vektorů probíhá v našem backendu, bez samostatné vektorové databáze.
Hledání podle významu pomáhá objevovat souvislosti i tam, kde se použitá slova liší.
Příprava vektorů probíhá na pozadí, takže redakce při ukládání článku nemusí čekat na její dokončení. Po změně textu se sémantické podklady postupně aktualizují. V administraci můžeme sledovat průběh zpracování i případné chyby.
Pokud se při hledání nepodaří získat vektor dotazu kvůli nedostupnosti služby nebo vypršení časového limitu, vyhledávání využije výsledky podle slov.
Další čtení podle významové blízkosti
Stejný základ nově využíváme také při doporučování dalšího čtení. Přednost mají související články vybrané redakcí. Zbývající místa může systém doplnit texty, jejichž obsah je významově nejbližší právě otevřenému článku.
Doporučení tak mohou propojit příběhy napříč rubrikami, i když nemají stejné štítky nebo podobný titulek. Vycházejí z obsahu článku, který právě čtete, nikoli z osobního profilu čtenáře.
Pro tento výběr porovnáváme již uložené vektory. Při otevření článku proto není potřeba posílat nový požadavek na tvorbu vektorů. Automatický výběr doplňuje redakční práci a nabízí další cestu, jak v archivu objevit text, ke kterému byste se jinak nemuseli dostat.
Přehlednější vývoj a společné ukládání změn
Relatude.DB umožňuje definovat nativní datový model pomocí typů a rozhraní jazyka C#. Struktura obsahu tak zůstává blízko kódu, který s ní pracuje. Silné typování pomáhá zachytit nesrovnalosti při sestavení aplikace a usnadňuje její údržbu.
Důležitá je také spolehlivost ukládání. Úprava článku může zahrnovat odstavce, autory, štítky i odkazy. Naše aplikace ukládá související databázové změny v jedné transakci, aby se provedly společně a při selhání nezůstala uložená pouze jejich část. Samotné nahrané soubory spravuje backend odděleně; databáze uchovává jejich metadata a vazby.
Otevřený základ pro další příběhy
Relatude.DB má veřejně dostupný zdrojový kód pod licencí MIT a umožňuje provoz ve vlastním prostředí. Můžeme tak lépe porozumět technologii, na které magazín stojí, a rozhodovat o jejím provozu i uložených datech. Zdrojový kód a licence
Nové jsme.cz už na tomto základu stojí. Jeho přínos chceme proměňovat v pohodlnější objevování příběhů a souvislostí — aby vás zajímavý článek přivedl k dalšímu a vy měli chuť pokračovat.